- DeepSeek-V4.1-Flash вышла 10 сентября 2026 года: это модель на 552 млрд параметров, из которых при генерации работают лишь 16 млрд.
- По заявлению DeepSeek и сторонних тестов, новая Flash обходит прежний флагман V4-Pro по качеству, скорости и цене, хотя почти втрое меньше его.
- В API модель называется deepseek-flash, держит контекст до 1 млн токенов, понимает изображения и стоит от 15 центов за миллион входных токенов в непиковые часы.
- С 14 сентября запросы к deepseek-v4-pro обслуживает V4.1-Flash по её тарифу, а V4.1-Pro компания пока только анонсировала без даты.
- Веса V4.1-Flash открыты на Hugging Face под лицензией MIT: модель можно запускать на своих серверах и использовать в коммерческих продуктах.
01Что такое DeepSeek V4.1 Flash — коротко
DeepSeek-V4.1-Flash — новая языковая модель китайской компании DeepSeek, выпущенная 10 сентября 2026 года. Это самая компактная модель новой архитектуры компании, но по результатам тестов она обходит прежний флагман DeepSeek-V4-Pro. Модель доступна бесплатно в чате и приложении DeepSeek, через платный API и в виде открытых весов.
Если вы ищете общий рассказ о компании, её истории и о том, как пользоваться чат-ботом на русском, начните с нашего обзора нейросети DeepSeek. Здесь речь только о свежем поколении V4.1 и о том, что изменилось для пользователей и разработчиков.
02Как устроена V4.1 Flash и почему она быстрее
V4.1-Flash построена по схеме «смесь экспертов» (MoE): внутри много специализированных подсетей, и на каждый токен включается лишь небольшая их часть. Всего у модели 552 млрд параметров — почти вдвое больше, чем у предыдущей V4-Flash с её 284 млрд. Но благодаря новой архитектуре Causal Encoder–Decoder при чтении запроса активны только 8 млрд параметров, а при генерации ответа — 16 млрд.
Второе важное изменение — кэш «ключ–значение», в котором модель хранит уже прочитанный контекст. DeepSeek перевела его в четырёхбитный формат с плавающей точкой: по данным SiliconANGLE, на один токен теперь уходит около 890 байт. Компания пишет, что новой модели нужна четверть прежней быстрой памяти HBM и восьмая часть места на SSD. Для длинных агентных сессий, где контекст тянется на сотни тысяч токенов, это прямая экономия.
Третье нововведение — встроенное зрение. Раньше для работы с картинками у DeepSeek была отдельная экспериментальная модель V4-Flash-Vision-Exp, вышедшая в августе. Теперь понимание изображений встроено прямо в V4.1-Flash, а старое имя модели в API перенаправляется на новую.
03DeepSeek V4.1 Flash, V4 Flash и V4 Pro: сравнение
Запросы «deepseek pro» и «deepseek 4.1» часто путают: V4.1-Pro ещё не вышла, а под «Pro» сейчас обычно понимают V4-Pro из апрельского поколения. Ниже — сводка по официальным карточкам моделей на Hugging Face и документации API.
| Параметр | V4-Flash | V4-Pro | V4.1-Flash |
|---|---|---|---|
| Выход | апрель 2026, превью | апрель 2026, превью | 10 сентября 2026 |
| Всего параметров | 284 млрд | 1,6 трлн | 552 млрд |
| Активных параметров | 13 млрд | 49 млрд | 8 млрд на входе, 16 млрд на выходе |
| Контекст | 1 млн токенов | 1 млн токенов | 1 млн токенов |
| Работа с картинками | только в отдельной версии Vision-Exp | нет | встроена |
| Лицензия весов | MIT | MIT | MIT |
| Статус в API | имя перенаправляется на V4.1-Flash | с 14 сентября перенаправляется на V4.1-Flash | основная модель deepseek-flash |
Главный вывод из таблицы: для большинства задач выбирать между Flash и Pro сейчас не нужно. DeepSeek сама перевела трафик Pro на новую Flash и обещает вернуть отдельную «тяжёлую» модель только с выходом V4.1-Pro.
04Насколько хороша V4.1 Flash: результаты тестов
DeepSeek опубликовала результаты в карточке модели, а SiliconANGLE сравнила их с американскими конкурентами. Сильнее всего V4.1-Flash выглядит в задачах программирования и работы в терминале — то есть там, где модели работают как ИИ-агенты, а не просто отвечают на вопросы.
| Тест | Что проверяет | V4.1-Flash |
|---|---|---|
| Terminal-Bench 2.1 | выполнение задач в командной строке | 90,6 |
| DeepSWE v1.1 | исправление кода в реальных репозиториях | 74,2 |
| GPQA Diamond | научные рассуждения уровня аспиранта | 90,9 |
По данным SiliconANGLE, на Terminal-Bench 2.1 модель опередила Claude Opus 5 с результатом 89,1 и GPT-5.6 Sol с 88,8, а на DeepSWE v1.1 почти сравнялась с Claude Opus 5, у которого 74%. В научных рассуждениях на GPQA Diamond американские модели, по оценке издания, всё ещё впереди. Как устроены такие модели и что означают эти тесты, мы объясняли в разборе о больших языковых моделях.
05Сколько стоит DeepSeek V4.1 Flash в API
Цены указаны на официальной странице Models & Pricing и действуют с 10 сентября 2026 года. DeepSeek сохранила пиковые и непиковые тарифы: в непиковое время всё стоит вдвое дешевле. Пиковыми считаются будние дни с 01:00 до 04:00 и с 06:00 до 10:00 по UTC, выходные и праздники — непиковые.
| Тариф | Вход без кэша, непик | Вход без кэша, пик | Выход, непик | Выход, пик |
|---|---|---|---|---|
| deepseek-flash (V4.1-Flash) | 15 центов | 30 центов | 60 центов | $1,20 |
| deepseek-v4-pro (прежний тариф Pro) | — | — | — | $3,96 |
В пересчёте на задачи разница заметная: SiliconANGLE отмечает, что пиковая цена выходных токенов у V4-Pro составляла $3,96 за миллион, а у V4.1-Flash — $1,20, то есть примерно на 70% меньше. Особенно дёшево обходится повторное чтение одного и того же контекста: при попадании в кэш миллион входных токенов стоит доли цента.
На странице цен deepseek-v4-pro пока указана отдельной строкой, но в анонсе DeepSeek сказано, что с 04:00 UTC 14 сентября 2026 года все запросы к этому имени обслуживает V4.1-Flash по её расценкам — до выхода V4.1-Pro. Перед тем как считать бюджет, сверьтесь с биллингом в личном кабинете.
06Как пользоваться DeepSeek V4.1 Flash: чат, приложение, API
По данным DeepSeek, V4.1-Flash работает сразу в трёх местах: в веб-чате, в мобильном приложении и на API-платформе. Для обычного пользователя ничего переключать не нужно — чат и приложение сами используют новую модель.
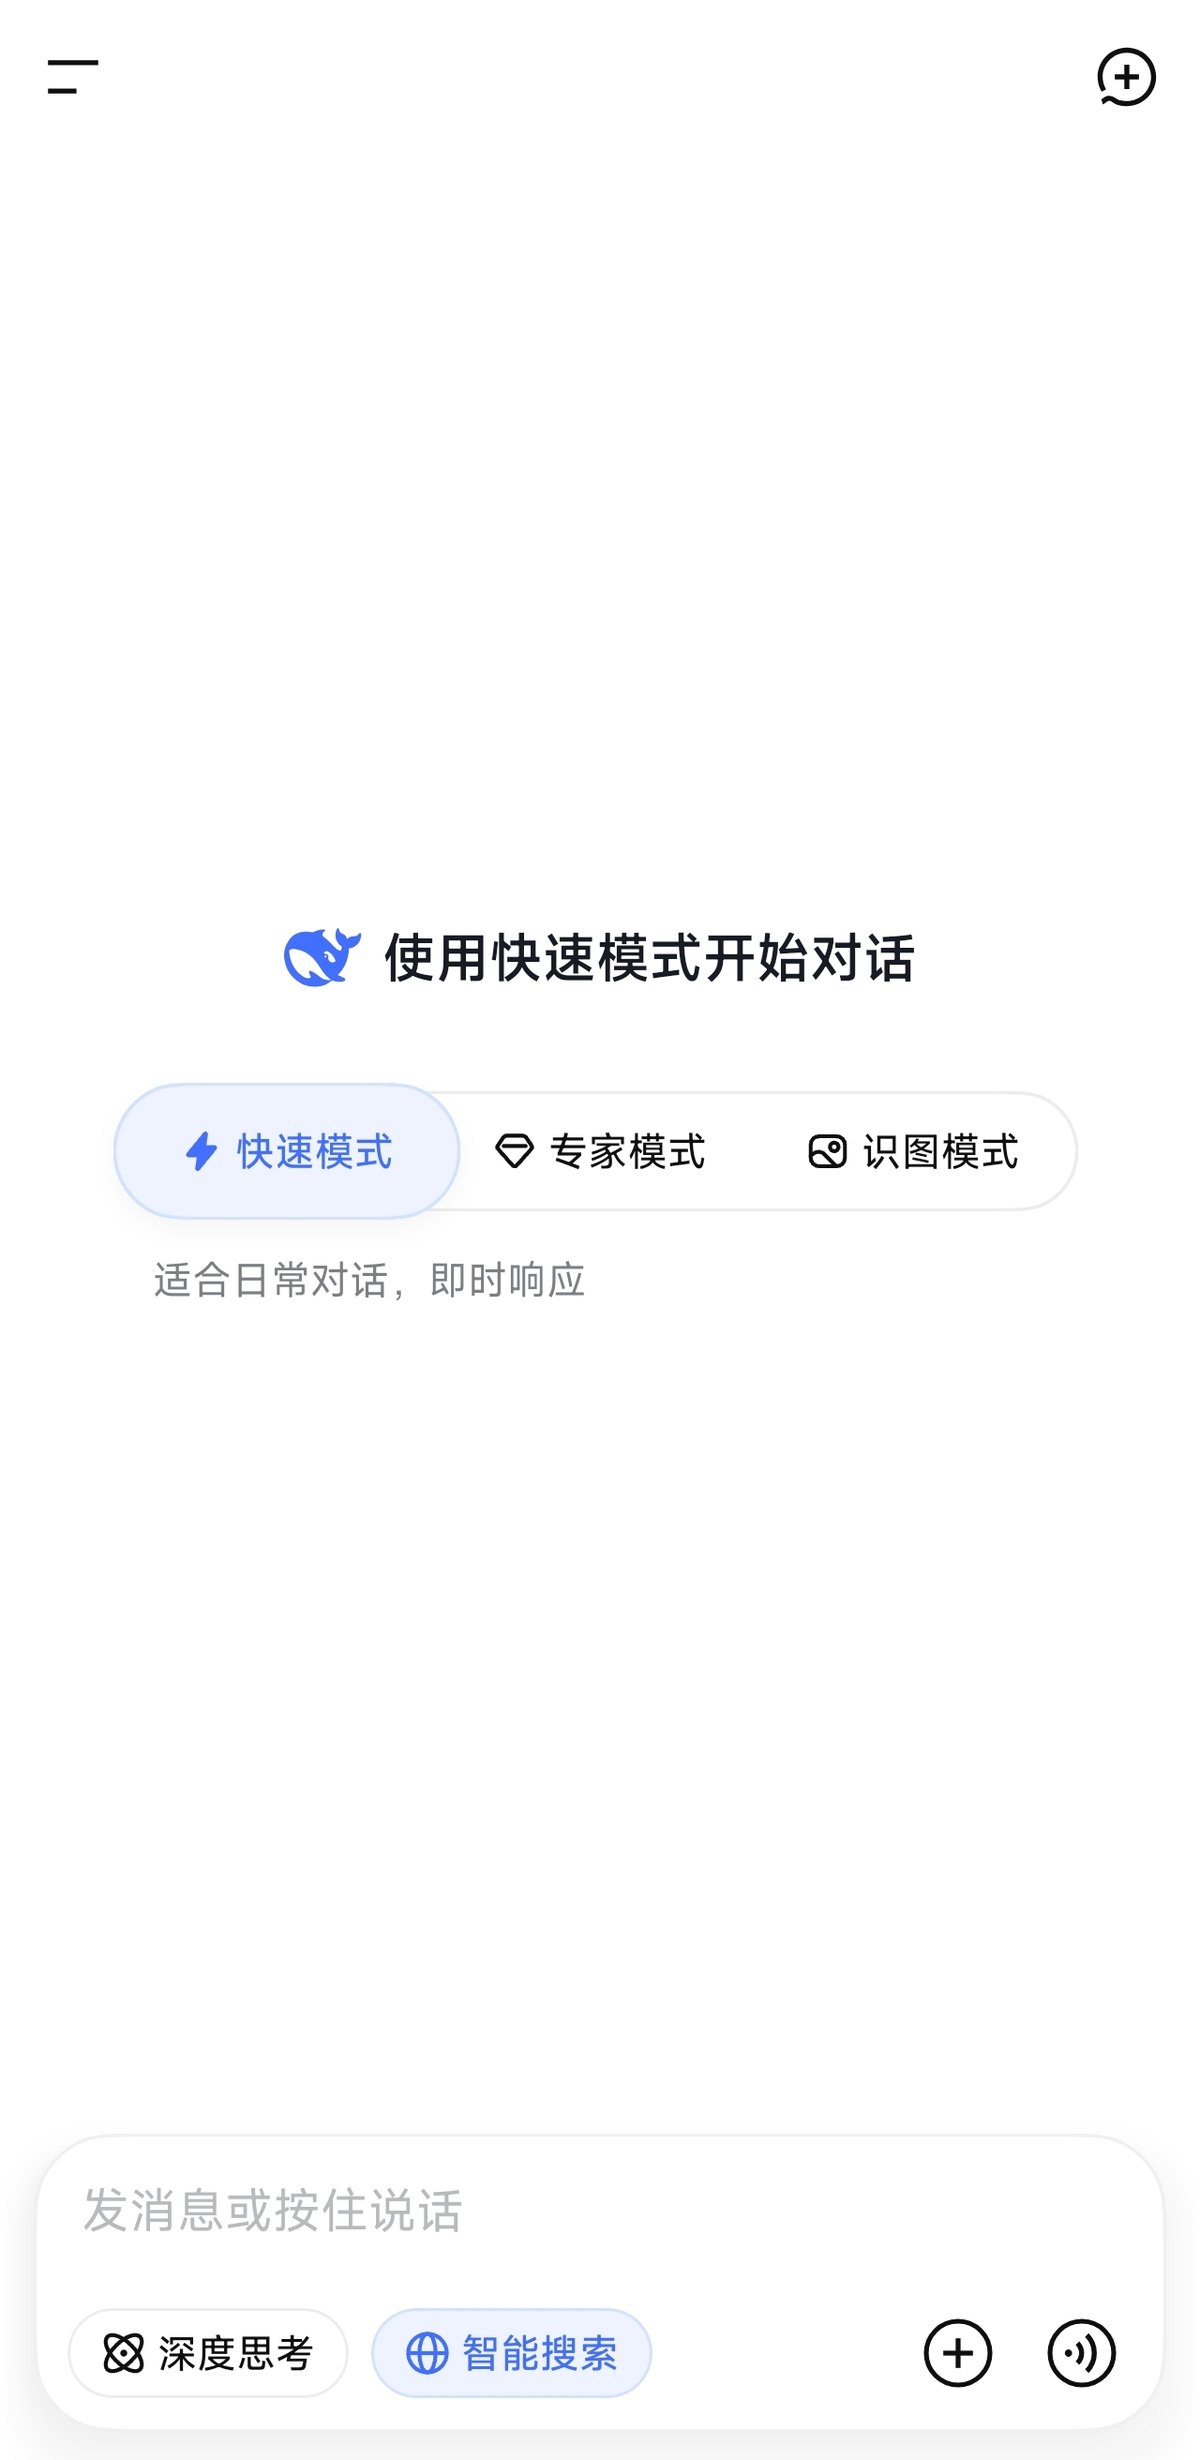
- 1Для чата откройте chat.deepseek.com или установите приложение DeepSeek для iOS и Android, войдите в аккаунт и пишите запрос на русском.
- 2Чтобы модель подумала дольше, включите режим рассуждений (thinking) — он полезен для математики, кода и сложного анализа.
- 3Для API зарегистрируйтесь на platform.deepseek.com, пополните баланс и создайте ключ в разделе API keys.
- 4В коде укажите имя модели deepseek-flash. API совместим с форматом OpenAI Chat Completions, а также с интерфейсом Anthropic, поэтому подойдут привычные SDK.
- 5Если у вас в коде остались имена deepseek-v4-flash или deepseek-v4-pro, запросы продолжат работать, но их обслуживает V4.1-Flash — лучше сразу перейти на новое имя.
- 6Для агентов используйте вызов инструментов (tool calls) и JSON-вывод: модель поддерживает оба режима и до 384 тыс. токенов на выходе.
Логика работы с ключами у DeepSeek такая же, как у OpenAI: ключ показывают один раз, хранить его нужно в переменных окружения, а не в коде. Подробнее о безопасном обращении с ключами — в нашем разборе ключей OpenAI API. Если вы собираете собственного помощника, пригодится инструкция как создать ИИ-агента.
07Открытые веса и лицензия: можно ли запустить DeepSeek у себя
Веса модели выложены на Hugging Face в репозитории deepseek-ai/DeepSeek-V4.1-Flash вместе с техническим отчётом. Лицензия — MIT: модель можно дообучать, встраивать в свои продукты и использовать коммерчески без отчислений DeepSeek. Для бизнеса это главный аргумент: данные не покидают ваш контур, а зависимость от одного облака снижается.
- Серверный запуск: карточка модели приводит команды для vLLM и SGLang, также поддерживается загрузка через Transformers.
- Домашний компьютер: квантованные версии доступны через llama.cpp, Ollama и LM Studio, но даже сжатой модели на 552 млрд параметров нужен очень мощный компьютер с большим объёмом памяти.
- Шаблон диалога: в релизе нет готового Jinja-шаблона чата, эталонная реализация лежит в папке encoding, а для продакшена DeepSeek советует свой набор deepseek-recipe.
08Что изменилось по сравнению с прошлыми версиями
Поколения DeepSeek меняются быстро. В 2025 году компания прошла путь от R1 и V3 до V3.1 с гибридными рассуждениями и V3.2, которую в декабре поставили в основу deepseek-chat и deepseek-reasoner. В апреле 2026 года вышло превью V4 в двух размерах — Pro и Flash — с контекстом в 1 млн токенов.
- 24 апреля 2026 — превью DeepSeek-V4: V4-Pro и V4-Flash, API в форматах OpenAI и Anthropic.
- 31 июля 2026 — официальный выпуск V4-Flash в публичной бете.
- 13 августа 2026 — общий доступ к V4-Pro с усиленными агентными функциями и уровнями рассуждений low, high и max.
- 21 августа 2026 — экспериментальная модель со зрением V4-Flash-Vision-Exp.
- 10 сентября 2026 — DeepSeek-V4.1-Flash, 14 сентября на неё переведён трафик V4-Pro.
По сравнению с V3.2 уже поколение V4 резко сократило затраты на длинный контекст: по данным карточки V4-Pro, при 1 млн токенов ей нужно 27% вычислений на токен и 10% кэша от уровня V3.2. V4.1-Flash продолжает эту линию, добавляя зрение и ещё более экономный кэш.
Сравнить DeepSeek с западными альтернативами поможет наш разбор Claude AI, а для программирования — материал о Claude Code. Если вас интересует доступность зарубежных сервисов из России, посмотрите разбор Gemini в России.
09Что это значит для бизнеса
Для компаний V4.1-Flash — один из самых дешёвых способов получить модель уровня флагманов в агентных задачах и программировании. Открытые веса под MIT позволяют развернуть её на собственном оборудовании, что важно для банков, медицины и госсектора, где данные нельзя отправлять во внешнее облако.
Есть и риски. Ряд стран ограничил использование приложения DeepSeek на служебных устройствах из-за вопросов защиты данных, а конкуренция США и Китая в ИИ остаётся острой — это видно и по итогам переговоров Трампа и Си Цзиньпина об ИИ. Облачный API DeepSeek обрабатывает данные на серверах компании, поэтому конфиденциальные документы разумнее гонять через локальную копию модели.
Сама DeepSeek при этом остаётся одним из самых заметных ИИ-стартапов Китая: по данным SiliconANGLE, в июне 2026 года компания привлекла более $7,4 млрд при оценке свыше $50 млрд.
Частые вопросы
Что такое DeepSeek Flash?
DeepSeek Flash — быстрая и недорогая линейка моделей DeepSeek. Актуальная версия V4.1-Flash вышла 10 сентября 2026 года, в API называется deepseek-flash и по тестам компании обходит прежний флагман V4-Pro.
Вышла ли DeepSeek V4.1 Pro?
Нет. DeepSeek анонсировала V4.1-Pro, но дату выхода не назвала. До её появления запросы к deepseek-v4-pro обслуживает V4.1-Flash по тарифу Flash.
Сколько стоит DeepSeek V4.1 Flash?
В чате и приложении модель бесплатна. В API миллион входных токенов без кэша стоит 15 центов в непиковые часы и 30 центов в пиковые, миллион выходных — 60 центов и $1,20 соответственно.
Что делать, если DeepSeek не работает?
Проверьте статус сервиса и попробуйте позже: при наплыве пользователей чат может отвечать с ошибками. Помогают обновление страницы, выход и повторный вход в аккаунт или переход из браузера в мобильное приложение; разработчикам стоит убедиться, что в коде указано актуальное имя модели deepseek-flash.
Как установить DeepSeek на компьютер?
Для обычной работы достаточно открыть веб-чат в браузере. Запустить саму модель локально можно через Ollama, LM Studio или llama.cpp с квантованными весами, но для V4.1-Flash нужен очень мощный компьютер с большим объёмом памяти.
Можно ли использовать DeepSeek V4.1 Flash в коммерческих проектах?
Да. Веса опубликованы на Hugging Face под лицензией MIT, которая разрешает коммерческое использование, дообучение и встраивание в собственные продукты.
Источники
- DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient — DeepSeek API Docsapi-docs.deepseek.com
- Models & Pricing — DeepSeek API Docsapi-docs.deepseek.com
- Change Log — DeepSeek API Docsapi-docs.deepseek.com
- Introducing DeepSeek-V4.1-Flash — DeepSeekwww.deepseek.com
- deepseek-ai/DeepSeek-V4.1-Flash — Hugging Facehuggingface.co
- deepseek-ai/DeepSeek-V4-Pro — Hugging Facehuggingface.co
- DeepSeek releases V4.1-Flash, says it outperforms flagship V4-Pro — SiliconANGLEsiliconangle.com