- Большая языковая модель (LLM) — нейросеть с миллиардами параметров, которая обучена предсказывать следующий фрагмент текста и благодаря этому умеет писать, переводить, резюмировать и программировать.
- Почти все современные LLM построены на архитектуре «трансформер», которую исследователи Google описали в 2017 году в статье «Attention Is All You Need».
- Модель сначала проходит предобучение на триллионах токенов, а затем дообучение на примерах и с обратной связью от людей (RLHF), чтобы стать полезным ассистентом.
- Главные игроки — GPT (OpenAI), Claude (Anthropic), Gemini (Google), Llama (Meta), DeepSeek, а в России — GigaChat (Сбер) и YandexGPT (Яндекс); часть моделей распространяется с открытыми весами.
- LLM ошибаются уверенно («галлюцинируют») и ограничены контекстным окном, поэтому в бизнесе их ответы нужно проверять, а важные данные — подавать в запрос явно.
- Использование ИИ быстро дешевеет: по оценке Epoch AI, цена фиксированного уровня качества падает примерно в 13 раз за год.
01Что такое большая языковая модель простыми словами
Большая языковая модель (Large Language Model, LLM) — это нейросеть с огромным числом параметров, обученная на гигантских массивах текста понимать и порождать естественный язык. По сути, она очень хорошо угадывает, какое слово или его часть должны идти дальше, — и из этого простого навыка вырастают ответы на вопросы, переводы, письма и программный код.
Русская Википедия определяет LLM как языковую модель на основе нейронной сети с множеством параметров — «миллиарды весовых коэффициентов и более». IBM формулирует похоже: это класс моделей глубокого обучения, натренированных на огромных объёмах данных и способных решать широкий круг задач с текстом и другим контентом. Именно такие модели стоят за ChatGPT, Claude, Gemini, «Алисой» и GigaChat.
02Как работает LLM: токены, трансформер и предсказание следующего слова
Модель не читает текст так, как человек. Сначала текст режется на токены — базовые единицы из нескольких символов: целое короткое слово, часть длинного слова, знак препинания. Каждый токен превращается в набор чисел (эмбеддинг), и дальше нейросеть работает уже с числами.
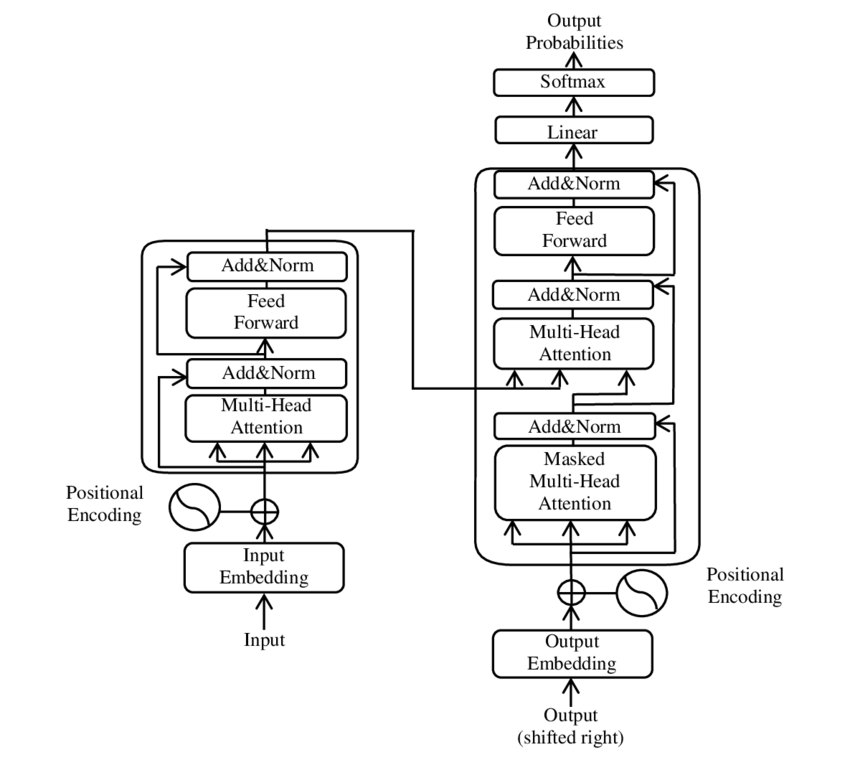
Сердце почти любой современной LLM — архитектура «трансформер». Её в 2017 году описали восемь исследователей, большинство из Google, в статье «Attention Is All You Need». Ключевая идея — механизм внимания (self-attention): для каждого токена модель вычисляет, насколько ему важны все остальные токены в тексте, даже очень далёкие. Так она понимает, к чему относится местоимение или какое слово в длинной фразе главное.
Мы предлагаем новую простую сетевую архитектуру — Трансформер, основанную исключительно на механизмах внимания и полностью отказывающуюся от рекуррентности и свёрток.
Ашиш Васвани и соавторы, аннотация статьи «Attention Is All You Need», arXiv, 2017
Когда вы задаёте вопрос, модель превращает его в токены, пропускает через десятки слоёв внимания и рассчитывает вероятности для всех возможных следующих токенов. Затем выбирает один, добавляет его к тексту и повторяет цикл. Ответ, который выглядит как связная мысль, на самом деле собирается по одному токену — как объясняет IBM, модель генерирует текст «token at a time».
03Как обучают большие языковые модели
Обучение LLM идёт в несколько этапов, и у каждого своя цель. Самый дорогой — первый: именно на нём модель получает «знания о мире» и чувство языка.
- 1Предобучение. Модели показывают триллионы токенов из книг, статей, сайтов и кода и учат предсказывать следующий токен. Разметка людьми не нужна: правильный ответ уже есть в самом тексте. Это самообучение (self-supervised learning).
- 2Дообучение на примерах (Supervised Fine-Tuning). Модель тренируют на наборах «запрос — хороший ответ», чтобы она следовала инструкциям, а не просто продолжала текст.
- 3RLHF — обучение с подкреплением на основе отзывов людей. Люди сравнивают варианты ответов, по их оценкам обучают модель вознаграждения, а она уже подстраивает LLM под предпочтения людей: быть полезной, вежливой, отказываться от вредных запросов.
- 4Специализация. Готовую модель можно дообучить на данных конкретной отрасли или компании — например, на юридических документах или переписке службы поддержки.
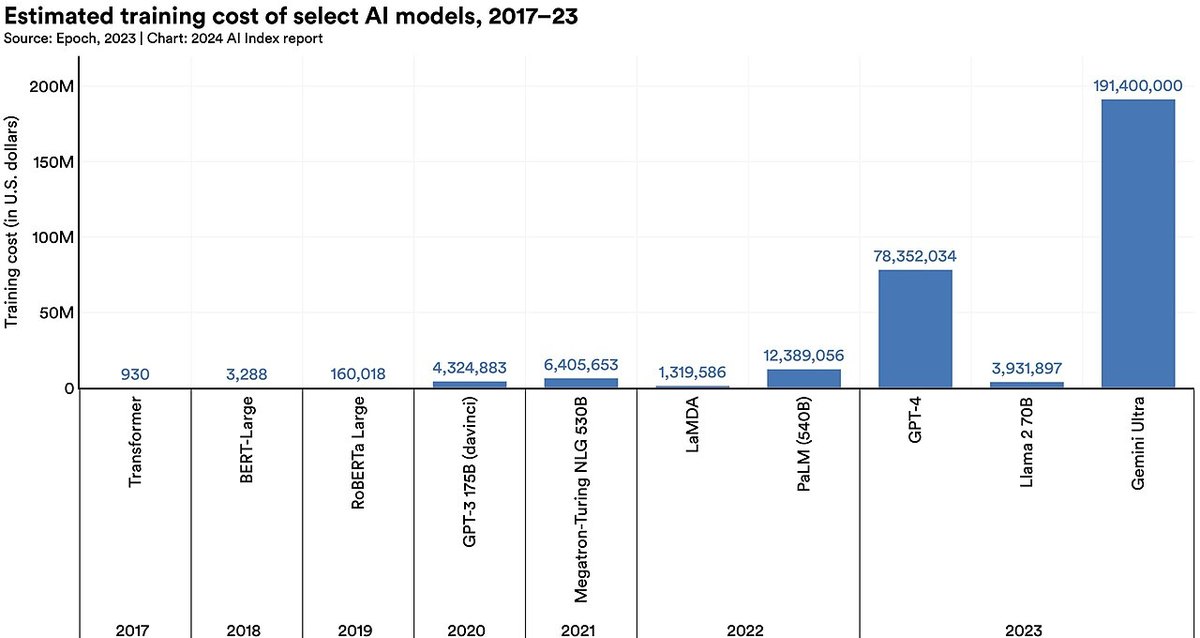
Предобучение стоит дорого и быстро дорожает с ростом моделей. По данным английской Википедии, обучение GPT-2 в 2019 году обошлось в $50 000, а обучение PaLM с 540 млрд параметров в 2022 году — в $8 млн. Поэтому базовые модели с нуля создают единицы компаний, а остальные строят продукты поверх готовых. Подробнее о том, где физически идут эти вычисления, — в разборе что такое дата-центр и зачем он нужен ИИ.
04Чем LLM отличается от нейросети и машинного обучения вообще
Эти понятия вложены друг в друга, как матрёшка. Машинное обучение — широкая область, где алгоритмы учатся на данных. Нейросети — один из подходов внутри неё. Большие языковые модели — частный случай нейросетей: огромные трансформеры, обученные на тексте. А генеративный ИИ — зонтичное название для моделей, которые создают новый контент: текст, картинки, музыку, видео.
| Понятие | Что это | Пример |
|---|---|---|
| Машинное обучение | Алгоритмы, которые находят закономерности в данных | Скоринг заёмщиков в банке, прогноз спроса |
| Нейросеть | Модель из слоёв искусственных «нейронов» с настраиваемыми весами | Распознавание лиц, голосовой ввод |
| Большая языковая модель | Нейросеть-трансформер с миллиардами параметров, обученная на тексте | GPT, Claude, Gemini, GigaChat |
| Генеративный ИИ | Модели, которые создают новый контент | LLM, генераторы изображений и видео |
Главное отличие LLM от «обычных» нейросетей — универсальность. Классическая модель решает одну задачу: определяет спам или распознаёт номер машины. Языковая модель без переобучения пишет пресс-релиз, переводит договор и пишет SQL-запрос — достаточно описать задачу словами. Поэтому, говоря про большие языковые модели и генеративный искусственный интеллект, обычно имеют в виду одно и то же семейство технологий.
05Примеры больших языковых моделей
История массовых LLM коротка. Трансформер появился в 2017 году, в 2018-м вышли BERT от Google и первая GPT от OpenAI, в 2020-м — GPT-3, доступная только через API. Перелом случился в конце 2022 года, когда OpenAI открыла публике ChatGPT. Сегодня рынок делят несколько крупных семейств моделей.
| Модель | Разработчик | Веса | Что важно знать |
|---|---|---|---|
| GPT | OpenAI (США) | Флагманские закрытые, есть открытая серия gpt-oss | Основа ChatGPT и API OpenAI |
| Claude | Anthropic (США) | Закрытые | Сильна в работе с длинными документами и коде |
| Gemini | Google (США) | Закрытые, открытые модели Google выпускает под маркой Gemma | Встроена в поиск, Android и сервисы Google |
| Llama | Meta (США) | Открытые | Одна из первых популярных моделей с открытыми весами |
| DeepSeek | DeepSeek (Китай) | Открытые | DeepSeek R1 — 671 млрд параметров |
| Mistral | Mistral AI (Франция) | Открытые и закрытые | Mistral 7B и Mixtral 8x7B выпущены под лицензией Apache |
| GigaChat | Сбер (Россия) | Основные версии закрытые, часть выложена открыто | Работает на русском и английском |
| YandexGPT | Яндекс (Россия) | В основном закрытые | Лёгкая YandexGPT 5 Lite Pretrain выложена на HuggingFace |
Открытые веса означают, что модель можно скачать и запустить на собственных серверах, не отправляя данные внешнему провайдеру. Закрытые модели доступны только через чат-сервис или API разработчика. Подробнее о каждой — в наших разборах: что такое OpenAI, Claude AI, DeepSeek, Gemini в России и нейросеть Алиса.
Российские модели появились в 2023 году: YandexGPT Яндекс представил 17 мая 2023 года, а GigaChat Сбер открыл для всех в сентябре того же года после закрытого тестирования. Гонка при этом не останавливается — Google, например, готовит Gemini 4.
06Где большие языковые модели применяются в бизнесе
LLM полезны везде, где много текста и повторяющихся операций с ним. IBM выделяет генерацию и перевод текстов, клиентскую поддержку, программирование и анализ отзывов. На практике список шире.
- Клиентский сервис: чат-боты, которые отвечают по базе знаний и передают сложные случаи оператору.
- Документы: краткие выжимки договоров, отчётов и совещаний, поиск по внутренним регламентам.
- Маркетинг и контент: черновики текстов, описания товаров, варианты заголовков — подробнее в разборе нейросеть для генерации текста.
- Разработка: написание и проверка кода, тесты, миграции.
- Аналитика: разбор отзывов и обращений, классификация заявок, извлечение данных из писем и сканов.
- Автоматизация процессов: LLM становится «мозгом» ИИ-агентов, которые сами выполняют цепочки действий, — см. что такое ИИ-агенты.
Массовость уже есть, отдача — пока нет. По данным McKinsey, 89% организаций регулярно используют ИИ хотя бы в одной функции, но лишь 37% видят положительный эффект на операционную прибыль. При этом вложения в ИИ-инфраструктуру растут быстрее, чем компании учатся превращать их в деньги.
07Ограничения LLM: галлюцинации, контекстное окно и стоимость
Главная проблема — галлюцинации. Модель может выдать ложную информацию, которая при этом звучит правдоподобно: несуществующую статью закона, выдуманную цитату, неверную цифру. Это следствие самого принципа работы: LLM подбирает вероятное продолжение, а не сверяется с базой фактов.
Второе ограничение — контекстное окно, то есть «рабочая память» модели: весь текст, который она учитывает при ответе, включая сам ответ. У GPT-2 окно было всего 1 тыс. токенов, у современных моделей Claude — до 1 млн токенов. Но документация Anthropic предупреждает: больше не значит лучше — с ростом числа токенов точность и полнота снижаются.
Третье — стоимость и ресурсы. Модели требуют много вычислений и энергии, а плата за API считается в токенах: чем длиннее запросы и ответы, тем дороже. Наконец, LLM наследуют неточности и предвзятость обучающих данных, а их знания ограничены датой, на которой закончилось обучение.
08Сколько стоит LLM и почему она дешевеет
Обучить модель уровня лидеров рынка стоит огромных денег, но пользоваться готовыми моделями становится всё дешевле. По подсчётам Epoch AI, цена достижения фиксированного уровня качества снижается примерно на 47% за квартал, или в 13 раз за год. Исследователи MIT оценивают чистый алгоритмический прогресс скромнее — примерно в 3 раза в год.
Пример из того же исследования: в начале 2025 года модель o3 решала научный тест GPQA Diamond на 75% примерно за 30 центов за вопрос, а спустя полтора года модель семейства GPT-5.6 показала тот же результат за 1/725 этой цены. Подробности — в нашей заметке о том, что стоимость ИИ падает быстрее, чем у любой технологии в истории. Для бизнеса вывод простой: задачи, которые год назад было невыгодно автоматизировать, стоит пересчитывать заново.
09Как выбрать большую языковую модель и начать работать
- 1Сформулируйте задачу. Поддержка клиентов, анализ договоров и генерация кода требуют разного: где-то важна точность, где-то скорость и цена.
- 2Проверьте ограничения по данным. Если работаете с персональными данными или коммерческой тайной, смотрите в сторону российских моделей или открытых весов, развёрнутых на своих серверах.
- 3Сравните несколько моделей на своих примерах. Возьмите пару десятков реальных запросов и оцените ответы вслепую — публичные рейтинги не всегда совпадают с вашей задачей.
- 4Посчитайте экономику. Оцените, сколько токенов уходит на типичный запрос, и умножьте на тарифы API и ожидаемый объём.
- 5Начните с пилота с человеком в контуре. Пусть модель готовит черновики, а сотрудник проверяет, — так вы увидите реальную пользу и типичные ошибки.
- 6Подключите свои данные. Когда пилот работает, дайте модели доступ к базе знаний, чтобы она отвечала по вашим документам, а не по памяти.
Частые вопросы
Большая языковая модель LLM — что это?
LLM (Large Language Model) — нейросеть с миллиардами параметров, обученная на огромных массивах текста предсказывать следующий токен. Благодаря этому она умеет отвечать на вопросы, писать и переводить тексты, резюмировать документы и программировать.
Как работает большая языковая модель на базовом уровне?
Модель разбивает текст на токены, превращает их в числа и с помощью механизма внимания архитектуры «трансформер» оценивает связи между ними. Затем она вычисляет вероятности следующего токена, выбирает его и повторяет цикл, собирая ответ по одному фрагменту.
Большая языковая модель — это нейросеть?
Да, LLM — частный случай нейросети: большой трансформер, обученный на тексте. Но не каждая нейросеть — языковая модель: нейросети распознают изображения, речь и решают множество других задач.
Какие есть примеры больших языковых моделей?
Самые известные — GPT от OpenAI, Claude от Anthropic, Gemini от Google, Llama от Meta и DeepSeek. В России это GigaChat от Сбера и YandexGPT от Яндекса, на которой работает «Алиса».
Что такое генеративные большие языковые модели?
Это LLM, которые создают новый текст, а не только классифицируют или анализируют существующий, — например, ChatGPT или Claude. Они входят в более широкую группу генеративного ИИ, куда относятся и генераторы изображений и видео.
Почему большие языковые модели ошибаются?
LLM подбирают вероятное продолжение текста, а не проверяют факты, поэтому могут уверенно выдавать ложную информацию — это называют галлюцинациями. Снизить риск помогает передача модели нужных документов в запросе и проверка ответов человеком.
Источники
- Большая языковая модель — Википедияru.wikipedia.org
- Large language model — Wikipediaen.wikipedia.org
- Vaswani et al. Attention Is All You Need — arXivarxiv.org
- IBM: What are large language models (LLMs)?www.ibm.com
- Anthropic: Context windows — документация Claudeplatform.claude.com
- GigaChat — Википедияru.wikipedia.org
- YandexGPT — Википедияru.wikipedia.org