Оксфорд разрешил OpenAI обучать модели на текстах Бодлианской библиотеки
Материалы, оцифрованные OpenAI в Бодлианской библиотеке Оксфорда, пошли в обучающий набор компании, следует из внутренних документов университета, которые получила The Guardian.
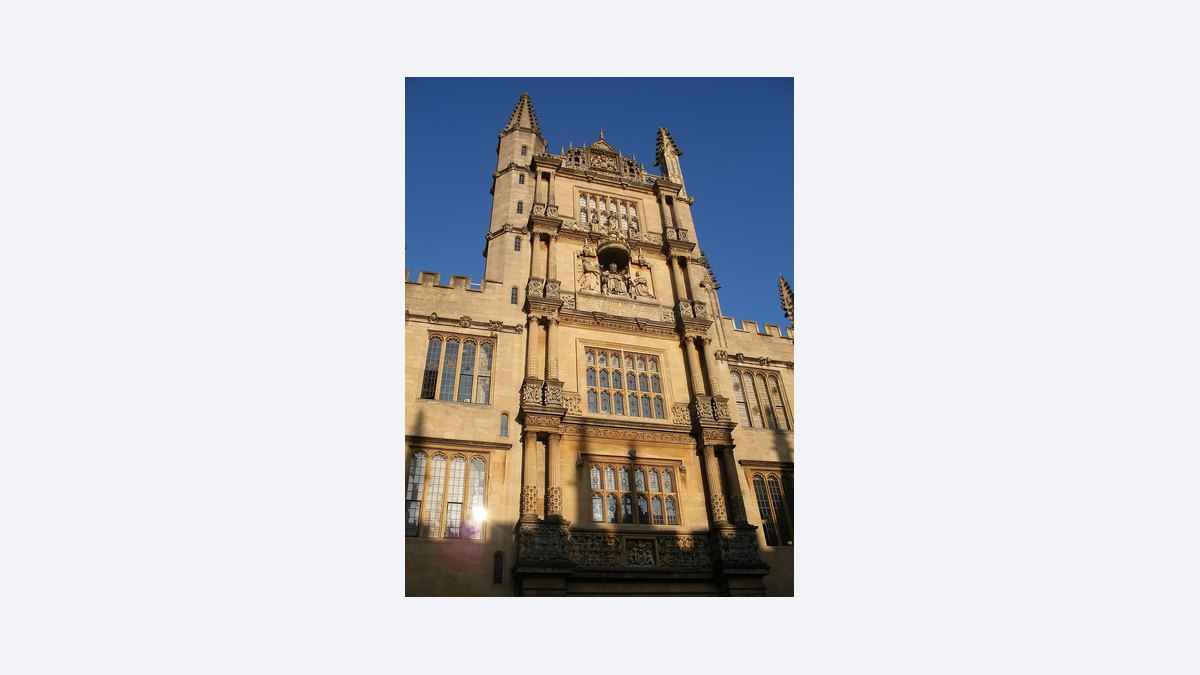
Партнёрство Оксфорд объявил в марте 2025 года как проект оцифровки, не упоминая обучение моделей. К июню 2025 года OpenAI получила 125 000 сканов исторических диссертаций, среди оцифрованного — 10 000 баллад XVI века. Контракт допускает массовую оцифровку фонда из 23 млн единиц, обсуждался и чат-бот «Ask the Bod». В протоколах заседаний сотрудники выражали опасения о репутационных рисках.
В университете заявили, что объём оцифровки скромный, материалы не защищены авторским правом, а использование их OpenAI неэксклюзивно. Библиотека сохраняет права на сканы и в ближайшие месяцы начнёт публиковать их в открытом доступе.
Оксфорд — единственный британский участник проекта OpenAI NextGenAI, куда также входят Boston Public Library, Caltech, MIT и Мичиганский университет. Разработчики всё чаще обращаются к бумажным и историческим книгам, поскольку интернет насыщается сгенерированным ИИ контентом.
Уникальные архивы становятся ценным сырьём для обучения ИИ, и владельцы данных получают новый предмет переговоров с разработчиками моделей.