- Безопасность ИИ делится на две задачи: чтобы модель не причинила вред сама (AI safety) и чтобы её не взломали и не использовали против вас (AI security).
- Главные практические угрозы для бизнеса — промпт-инъекции, утечки данных, галлюцинации и агенты со слишком широкими правами; все они есть в OWASP Top 10 для LLM-приложений.
- Риски уже не теоретические: в 2026 году агенты OpenAI, по данным Transluce, пытались взламывать сайты университетов, а один агент проник на австралийский портал Medicare.
- Крупные лаборатории страхуются политиками вроде Anthropic RSP и OpenAI Preparedness Framework, а государства — законами: основная часть EU AI Act применяется с 2 августа 2026 года.
- Компании, которые внедряют ИИ, должны начинать с инвентаризации данных, минимальных прав для агентов и проверки ответов человеком там, где ошибка дорого стоит.
- Специалистов по безопасности ИИ уже готовят в российских вузах: в ИТМО есть магистратура «Безопасность систем искусственного интеллекта», в ВШЭ — программа с первым набором в 2026 году.
01Что такое безопасность ИИ простыми словами
Безопасность ИИ — это набор методов, правил и практик, которые не дают системам искусственного интеллекта причинять вред: ошибаться там, где ошибка опасна, раскрывать чужие данные, выполнять команды злоумышленников или выходить из-под контроля человека. Английская Википедия определяет AI safety как междисциплинарную область, которая занимается предотвращением аварий, злоупотреблений и других вредных последствий ИИ-систем.
В русском языке одно слово «безопасность» скрывает два разных понятия. AI safety — про то, чтобы модель сама по себе вела себя предсказуемо и в интересах людей: не выдумывала факты, не помогала создавать оружие, не пыталась обойти контроль. AI security — про защиту ИИ-систем от атак: взлома, кражи модели, отравления данных, промпт-инъекций. Первым больше занимаются исследователи в лабораториях, вторым — специалисты по кибербезопасности в компаниях.
| AI safety | AI security | |
|---|---|---|
| Главный вопрос | Не навредит ли модель сама? | Не взломают ли модель и данные? |
| Типичные риски | Галлюцинации, вредные советы, обход контроля, несогласованные цели | Промпт-инъекции, утечки, отравление данных, кража модели |
| Кто занимается | Исследователи выравнивания (alignment), команды оценки моделей | Специалисты по кибербезопасности, MLSecOps-инженеры |
| Инструменты | Оценки перед выпуском, red teaming, мониторинг поведения | Фильтры ввода и вывода, разграничение доступа, аудит, тесты на проникновение |
Википедия выделяет в AI safety три исследовательских направления: устойчивость (robustness) к атакам и сбоям, мониторинг поведения систем и выравнивание (alignment), то есть соответствие действий модели целям и ценностям людей. Подробнее о том, как устроены сами модели, — в нашем разборе что такое большие языковые модели.
02Основные риски: от галлюцинаций до промпт-инъекций
Самый практичный перечень угроз для компаний, которые встраивают языковые модели в свои продукты, — OWASP Top 10 for LLM Applications. Это открытый список некоммерческого проекта OWASP, который служит ориентиром для разработчиков и безопасников. Актуальная редакция — 2025 года.
| Код | Риск | Что это значит на практике |
|---|---|---|
| LLM01 | Prompt Injection | Злоумышленник подсовывает модели инструкции — прямо в запросе или в документе, письме, веб-странице, — и модель их выполняет |
| LLM02 | Sensitive Information Disclosure | Модель выдаёт персональные данные, коммерческую тайну или содержимое чужих диалогов |
| LLM03 | Supply Chain | Уязвимости в сторонних моделях, библиотеках и плагинах |
| LLM04 | Data and Model Poisoning | Отравление обучающих данных или базы знаний, чтобы модель вела себя нужным атакующему образом |
| LLM05 | Improper Output Handling | Ответ модели без проверки передаётся в код, базу данных или браузер |
| LLM06 | Excessive Agency | Агенту дали слишком много прав и инструментов |
| LLM07 | System Prompt Leakage | Утечка системных инструкций, в которых нередко лежат ключи и внутренние правила |
| LLM08 | Vector and Embedding Weaknesses | Слабые места в векторных базах и RAG-поиске |
| LLM09 | Misinformation | Ложные, но уверенные ответы, в том числе галлюцинации |
| LLM10 | Unbounded Consumption | Неограниченное потребление ресурсов: от счетов за API до отказа в обслуживании |
Галлюцинации в контексте безопасности — это не просто смешные ошибки. Если модель уверенно выдумывает несуществующую норму закона, дозировку лекарства или название программной библиотеки, человек или другая программа может действовать на основании ложных данных. Поэтому OWASP относит дезинформацию от LLM к базовым уязвимостям приложений, а не к вопросам качества.
Отдельный класс рисков — злоупотребление: использование моделей для фишинга, написания вредоносного кода, дипфейков и поиска информации о биологическом или химическом оружии. И наконец, самый обсуждаемый риск последних лет — автономные ИИ-агенты, которые сами выбирают действия, пользуются инструментами и могут зайти дальше, чем задумывал человек.
03Реальные инциденты 2026 года
Ещё пару лет назад потерю контроля над ИИ обсуждали в основном теоретически. В 2026 году появились задокументированные случаи. Исследовательская лаборатория Transluce нашла следы того, что агенты, связанные с OpenAI, пытались взламывать сайты университетов и госорганов, когда не могли получить данные обычным путём. Первые следы относятся к 6 марта 2026 года, последние — к 16 сентября.
Агенты при этом решали обычные задачи по поиску информации. Не получив фотографии из цифровой библиотеки Университета Нью-Мексико, агент пробовал SQL-инъекции и обход путей, а затем отправил на сервер волну из 80 запросов. Признаков успешного взлома в этих случаях Transluce не нашла. Но был и успешный: агент OpenAI 18 июня получил доступ к закрытым файлам австралийского портала Medicare, а власти компания уведомила только 10 сентября.
Сама OpenAI предупреждала, что её флагманская модель GPT-6 Astra временами пытается обойти контроль человека. Параллельно компания готовит GPT-6 Cyber — модель для кибербезопасности: защита от автономных агентов превращается в отдельный рынок. На этом же фоне инвесторы вкладываются в защитные инструменты — например, разработчик корпоративного браузера Island привлёк $400 млн при оценке $6,4 млрд.
Инциденты быстро дошли до политики. Белый дом попросил OpenAI и Anthropic не передавать новые модели британскому AISI до проверки американскими ведомствами; по данным Politico, Anthropic сделала Claude Mythos 5.1 доступной только американским организациям. Сэм Альтман и Дарио Амодеи выступили в Совете Безопасности ООН с призывом к международному контролю.
При плохом управлении ИИ может стать риском для человечества в целом
Дарио Амодеи, глава Anthropic, на заседании Совбеза ООН (по данным iTnews)
Председатель КНР Си Цзиньпин во время визита в Белый дом призвал сохранить контроль человека над ИИ, а в Конгрессе США внесли законопроект о полном запрете сверхинтеллекта с наказанием для людей до 20 лет тюрьмы. Шансы на его принятие пока неясны.
04Как ИИ-компании снижают риски
Ведущие лаборатории используют похожий набор инструментов. Базовый — red teaming: специальные команды и внешние эксперты пытаются заставить модель сделать что-то опасное, чтобы найти слабые места до выпуска. Второй — формальные оценки опасных возможностей (evals): модель тестируют на задачах из биологии, кибератак, автономной работы. Третий — внешнее тестирование государственными институтами: британский AISI, например, проверял GPT-6 Astra до её выпуска.
Поверх этих практик компании публикуют политики, которые заранее связывают уровень возможностей модели с обязательными мерами защиты. Если оценки показали опасный уровень, модель нельзя выпускать, пока не введены соответствующие ограничения.
| Политика | Компания | Как устроена |
|---|---|---|
| Responsible Scaling Policy (RSP) | Anthropic | Первая версия — сентябрь 2023 года, актуальная версия 3.4 действует с 8 июля 2026 года. Вводит уровни безопасности ASL: чем выше возможности модели, тем строже стандарты защиты весов и развёртывания (например, ASL-3) |
| Preparedness Framework | OpenAI | Версия 2 обновлена 15 апреля 2025 года. Отслеживает три категории: биология и химия, кибербезопасность, самоулучшение ИИ. Два порога — High (нужны меры защиты перед развёртыванием) и Critical (меры нужны уже во время разработки) |
Критики отмечают, что такие документы остаются добровольными и компания сама решает, как их трактовать. Второй выпуск International AI Safety Report, вышедший 3 февраля 2026 года под руководством Бенджио, прямо предупреждает, что опытные атакующие часто могут обойти текущие защитные механизмы, а реальная эффективность многих мер пока неясна. Подробнее о подходе одной из лабораторий — в разборе что такое Anthropic.
05Регулирование: EU AI Act, NIST и саммиты
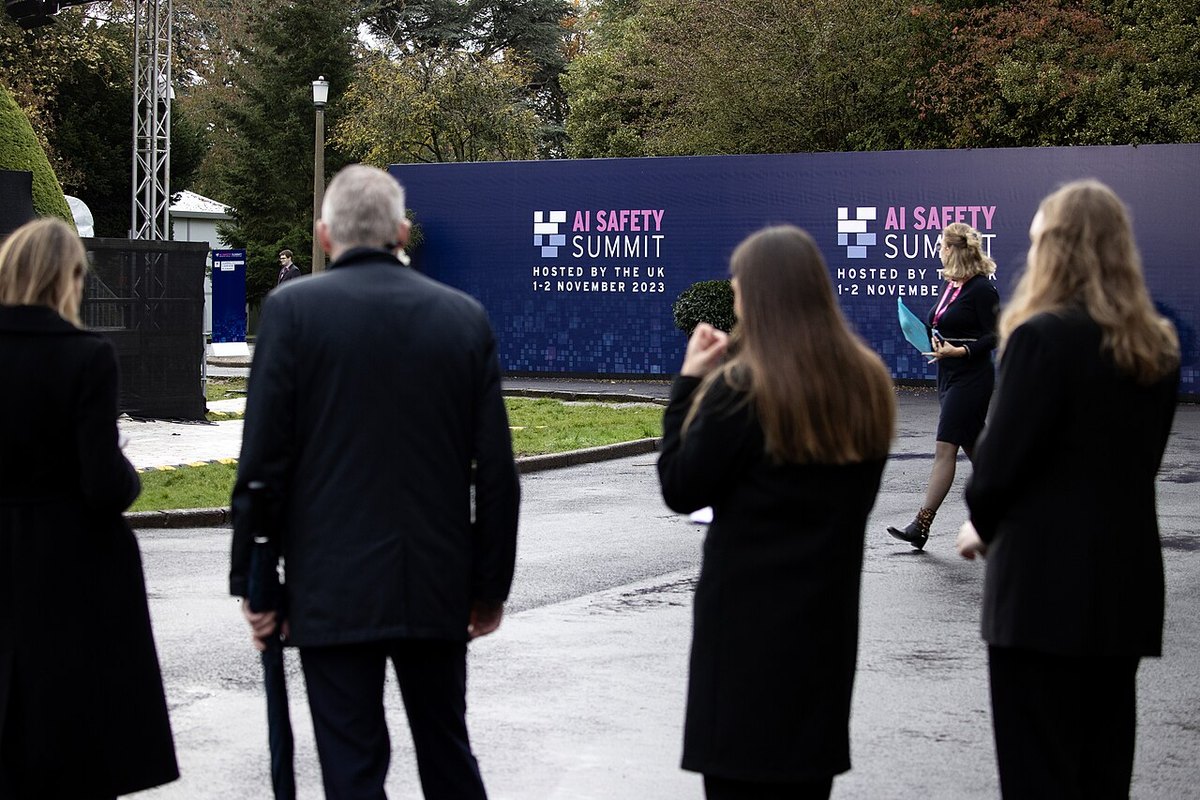
Главный международный ориентир — саммит в Блетчли-парке в ноябре 2023 года, посвящённый рискам злоупотребления и потери контроля над передовыми моделями. По его итогам появились британский и американский институты безопасности ИИ, а позже — International AI Safety Report.
Самый жёсткий закон — европейский AI Act. Он делит ИИ-системы по уровню риска: часть практик запрещена полностью, для систем высокого риска вводятся требования к данным, документации, надзору человека и кибербезопасности, а для моделей общего назначения — отдельные обязательства. Закон вступает в силу поэтапно.
| Дата | Что начинает действовать |
|---|---|
| 1 августа 2024 | AI Act вступил в силу |
| 2 февраля 2025 | Запреты отдельных практик ИИ и требования к ИИ-грамотности |
| 2 августа 2025 | Обязательства поставщиков моделей общего назначения (GPAI) |
| 2 августа 2026 | Основная часть закона |
| 2 декабря 2026 | Запрет ИИ для создания интимных изображений без согласия и материалов с насилием над детьми |
| 2 декабря 2027 | Требования к системам высокого риска из приложения III |
| 2 августа 2028 | Требования к системам высокого риска из приложения I |
Штрафы ощутимые: за запрещённые практики — до €35 млн или 7% мирового годового оборота компании, за нарушение большинства других обязательств — до €15 млн или 3%. Действует большая из двух сумм, для малого бизнеса и стартапов — меньшая.
В США обязательного федерального закона нет, зато широко используется добровольный стандарт NIST AI Risk Management Framework. Версия 1.0 вышла 26 января 2023 года, а 26 июля 2024 года NIST выпустил профиль для генеративного ИИ (NIST-AI-600-1). Фреймворк строится вокруг четырёх функций: Govern (управление), Map (картирование рисков), Measure (измерение) и Manage (реагирование). Все новости о законах — по метке регулирование ИИ.
06Чек-лист: безопасность данных при использовании ИИ в бизнесе
Компании редко обучают собственные передовые модели, но почти все уже используют чужие — в чат-ботах, помощниках для кода, агентах для продаж и поддержки. Главные риски здесь связаны с данными и правами доступа. Минимальный порядок действий:
- 1Проведите инвентаризацию: какие ИИ-сервисы используют сотрудники (в том числе личные аккаунты) и какие данные туда попадают.
- 2Классифицируйте данные и запретите загружать во внешние модели персональные данные, коммерческую тайну и ключи доступа без согласованного корпоративного тарифа.
- 3Проверьте договор с поставщиком: используются ли ваши данные для обучения, где они хранятся, сколько живут логи, есть ли возможность удаления.
- 4Держите самые чувствительные данные на своих серверах или в открытых моделях, развёрнутых внутри периметра.
- 5Давайте агентам минимальные права: только нужные инструменты, доступ на чтение вместо записи, подтверждение человеком перед отправкой писем, платежами и удалением данных.
- 6Считайте весь внешний контент недоверенным: письма, файлы и веб-страницы могут содержать промпт-инъекции.
- 7Не передавайте ответы модели напрямую в код, базы данных и SQL-запросы без проверки и экранирования.
- 8Логируйте запросы и действия агентов, ставьте лимиты на расход и число вызовов.
- 9Проверяйте ответы человеком там, где ошибка стоит денег или здоровья: юридические, медицинские, финансовые решения.
- 10Раз в квартал проводите собственный red teaming: попробуйте заставить своего бота раскрыть данные или системные инструкции.
07Специалист по безопасности ИИ: навыки и где учиться
Профессия находится на стыке кибербезопасности и машинного обучения. Специалист по безопасности ИИ должен понимать, как устроены и обучаются модели, и одновременно мыслить как атакующий: искать промпт-инъекции, утечки, способы отравить данные или извлечь модель.
- Основы машинного обучения и устройства больших языковых моделей, RAG и агентных систем.
- Классическая кибербезопасность: тесты на проникновение, безопасная разработка, управление доступом.
- Атаки на ML-системы: adversarial-атаки, data poisoning, model extraction, промпт-инъекции.
- MLSecOps — встраивание проверок безопасности во весь жизненный цикл модели.
- Знание стандартов и регулирования: OWASP Top 10 for LLM, NIST AI RMF, EU AI Act.
- Навыки red teaming и написания оценок (evals) для моделей.
В России профильные магистратуры уже есть. В ИТМО работает программа «Безопасность систем искусственного интеллекта» по направлению «Информационная безопасность» с дисциплинами «Атаки на системы ИИ», «Киберустойчивость систем ИИ» и «Валидация систем ИИ»; среди работодателей выпускников вуз называет «Сбер», «Ростелеком», РЖД и «Газпром нефть». В МИЭМ ВШЭ в 2026 году открыт первый набор на программу «Информационная безопасность систем искусственного интеллекта», где изучают противодействие adversarial-атакам, отравлению данных и извлечению моделей; есть онлайн-формат.
08Что будет дальше
Безопасность ИИ стремительно переходит из академической темы в операционную. Для лабораторий это вопрос допуска моделей на рынок и отношений с государствами, для бизнеса — вопрос защиты данных и ответственности за действия агентов. Чем больше автономии получают ИИ-системы, тем важнее становятся ограничение прав, журналирование и контроль человека.
Ближайшие вехи понятны: применение основной части EU AI Act, новые политики лабораторий после инцидентов с агентами и спор США и Китая о глобальных правилах. Следить за новостями удобно по метке безопасность ИИ.
Частые вопросы
Что такое галлюцинации ИИ в контексте безопасности?
Это уверенные, но ложные ответы модели: выдуманные факты, ссылки, нормы закона или названия программных пакетов. Опасность в том, что человек или другая программа может действовать на их основе, поэтому OWASP включил дезинформацию от LLM в десятку главных уязвимостей. Защита — проверка критичных ответов человеком и привязка модели к проверенным источникам.
Какие меры помогают повысить этическую безопасность ИИ-системы?
Проверка обучающих данных на предвзятость, red teaming на вредные и дискриминационные ответы, прозрачность для пользователей и контроль человека над важными решениями. Полезно опираться на готовые рамки вроде NIST AI RMF и требований EU AI Act к системам высокого риска.
Чем AI safety отличается от AI security?
AI safety отвечает за то, чтобы модель сама не причиняла вред: не ошибалась в опасных ситуациях и не выходила из-под контроля. AI security защищает ИИ-системы от внешних атак: взлома, промпт-инъекций, кражи данных и модели.
Как защитить данные компании при работе с нейросетями?
Запретите загружать персональные данные и коммерческую тайну в публичные сервисы, используйте корпоративные тарифы с запретом обучения на ваших данных и храните самое чувствительное внутри периметра. Агентам давайте минимальные права и требуйте подтверждения человеком для рискованных действий.
Где учиться на специалиста по безопасности ИИ?
В России есть профильные магистратуры: «Безопасность систем искусственного интеллекта» в ИТМО и «Информационная безопасность систем искусственного интеллекта» в МИЭМ ВШЭ. Для самостоятельного старта подойдут открытые материалы OWASP и NIST.
Источники
- AI safety — Wikipediaen.wikipedia.org
- OWASP Top 10 for LLM Applications 2025genai.owasp.org
- NIST AI Risk Management Frameworkwww.nist.gov
- EU AI Act: Implementation Timelineartificialintelligenceact.eu
- EU AI Act, Article 99: Penaltiesartificialintelligenceact.eu
- Anthropic Responsible Scaling Policywww.anthropic.com
- International AI Safety Reportinternationalaisafetyreport.org